容器日志把磁盘写满怎么办
时间:2026-11-15 15:36:07 来源:本站整理 作者:testai 热度: 0 次
容器一跑起来,日志就成了没人管的黑洞:单文件没有上限、调试输出忘了关、异常时同一行错误刷几万次,某天早上根分区就只剩几个百分点。这篇按日志怎么长大、轮转参数怎么设、留多久合适、盘不够了补盘还是换机、集中收集之后本地还留不留、大容量盘和固态盘怎么分工的顺序讲,含可直接改的参数和按量估算的方法。
跑容器的人大多遇到过这种场面:某天早上监控告警说根分区只剩几个百分点,登上机器一看,一个不起眼的日志文件已经涨到几十 GB 而且还在往上走。容器把应用输出全丢到标准输出,再由运行时写到文件,只要业务里有一条循环打日志的代码,或者某个库默认开着调试输出,盘被吃掉只是时间问题。这篇按日志怎么长大、轮转参数怎么设、留多久合适、盘不够了怎么补、要不要集中收集、机器怎么挑的顺序讲,尽量给出能直接改的数字和能直接对照的场景。
容器日志是怎么把盘写满的
日志不只一个来源。应用自己写的文件、运行时接管的容器输出、系统层的运行日志、反向代理的访问记录,四条线同时往盘里灌;只盯着其中一处,被吃满的常常是那个没人管的目录。
容器输出默认没有上限。用 json-file 驱动时一个容器的日志文件可以一路长到底,除非在守护进程配置里显式限制单文件大小和保留份数,否则它只会随业务量一直涨。
打印频率直接决定速度。一条每请求打印一行、每行两百字节的日志,在每秒几十个请求的站点上一天就是几个 GB;如果还带上堆栈或请求体,量级再翻几倍,一周就能吃掉几十 GB。
调试开关忘了关最要命。上线前为了排查打开详细输出,事后没人收尾,每一帧数据库查询都记一遍,盘就是这么一天天被填满的,发现时往往已经过了半个月。
异常时的日志会瞬时暴涨。程序陷入重试循环、连接池打满、磁盘自己报错,这几种情况会让同一行错误在几秒内重复上万次,一晚上的增量能顶平时一周。
镜像层和容器可写层同样吃空间。容器里临时下载的包、构建残留、被删掉但还挂在进程上的文件,du 看不到却实实在在占着空间,重启才释放。
报警阈值要早设。等到磁盘百分之百才收到通知,服务早就写不进去了;八成开始提醒,配合增长速率一起看,才留得出处理时间。

日志轮转参数怎么设
单文件上限先定住。按天算量,一天 500MB 的业务把单文件设成 100MB、保留 5 份,转起来刚好覆盖一天;设成 1GB 一份,出问题想翻最近十分钟的记录都费劲,还得先找对文件。文件名带上日期和序号,翻的时候不用猜哪份是最新的;轮转时间错开业务高峰,压在整点时磁盘写和业务写撞在一起,响应会明显变慢。
份数按保留天数乘每日转数。想留七天、每天转两次,那就是 14 份,少一份少半天,多一份白占空间;把这个乘法写进注释,后面接手的人一看就明白为什么是 14 这个数。份数还要和总量对一遍,14 份乘以 100MB 约 1.4GB,占根盘的比例心里得有数;份数堆太多,盘一满服务先挂,留再多也读不到。
压缩要打开。文本日志的压缩比通常在三到五倍,轮转完立刻打包,空间能省一大截,代价是查历史日志要多解压一步,日常排障仍然看未压缩的那份。压缩参数用默认就够,为了极限压缩把 CPU 拉满不划算,日志量大的机器上压缩本身也是一笔开销;归档目录单独挂盘,压缩包写到业务盘上等于白压。
容器侧的参数在守护进程里改。单文件大小与份数一起设,改完重启服务才生效,已有的大文件要手工清一次,否则限额只管新文件,旧的那几个还能再撑几个月。改之前在测试机跑一遍,确认新参数不会丢行,有些业务靠日志对账,截断太狠会缺证据;轮转之后挂一个清理任务,把超过保留天数又没被自动删掉的漏网文件扫掉。
日志该留多久 留多少
先问日志用来干什么。只为排障,七天到两周足够;要做审计或合规留存,那就是按月甚至按年算,两者的量级差出一个数量级,先定用途再定天数,用途变了策略也要跟着改,别一次定完就再也不看。
分级别留。错误和告警长期留,普通信息留一周,调试级别只留到问题关闭为止;混在一个目录里,等于用最贵的方式存最没用的数据,级别阈值调低一格,留存的量就能降一大截。
按业务重要性分。支付、登录这类路径的日志值得多留,静态资源访问记录留三天都嫌多;同一条规则套全站,要么不够用,要么浪费一半空间,按目录分组设规则比一刀切省事得多。
冷数据搬走。超过一个月的日志压完转到便宜的大容量盘,在线盘只留热的那部分,查历史时再拉回来,在线盘的寿命也能延长不少,转存交给脚本每周跑一次,别靠人记。
留存策略要写进文档。谁定的、什么时候复核、容量涨了怎么调,写清楚才不会半年后没人敢删,也不会一删就把正要用的记录清掉,复核周期定成季度,和容量评审一起做。
别忘备份侧。日志目录如果被一起打包进每日备份,等于占用双份空间,备份策略里要单独排除或者单独归档,恢复演练时也别把日志卷一起拉。

盘不够了是换盘还是换机器
先看增长曲线。平稳增长说明是容量问题,加盘或者换大容量机型就够;阶梯式暴涨说明有事件,先把源头掐住再谈扩容,否则新盘一样会在几周内被填满。监控里把日志目录单列出来看趋势,比看整盘占用有用得多,把最近七天的日增量列成一行数字,加盘还是清源一眼就能判断,连续三天阶梯上跳基本就是有异常日志在刷,先去源头。
看盘位和接口。大容量机械盘适合放日志和归档,单盘 6TB 起步,单位成本低,顺序写也能跑到一百多 MB 每秒;固态盘适合放正在写的热日志和高并发小文件,价格高但随机写不拖慢业务。盘位数有限时优先把接口留给机械大盘,固态只放系统和小库,机器只能装两块盘时优先保证日志盘容量,系统盘小一点没关系,日志盘留出两三倍余量,免得半年后再折腾一次。
看整体瓶颈。如果 CPU 和内存也常年七成以上,只加盘等于给旧车换轮胎,不如直接换一台配置更宽的机器;如果只有存储吃紧,加盘最省。判断标准很简单,看扩容之后有没有别的指标顶在门口,有就别只补存储,扩容和清源同时做,效果比单纯加盘好得多,先止血再扩容,顺序反了只是把问题推后一个月。,扩容之后先把旧日志归档一批再上业务,新盘才有余量应付下一轮增长,不然三个月又满,顺序反了等于白花钱
集中收集之后本地还留不留
集中收集解决的是查得快。几十台机器的日志收到一个地方,按请求编号一搜就能串起整条链路,比逐台登录搜索快太多,链路一串,定位时间能从半小时降到几分钟。
本地仍要留短期缓冲。采集端断连、网络抖动时,本地文件是唯一兜底,一般留一到三天,够撑到采集恢复,缓冲目录也要限总量,别让兜底变成新的黑洞。
采集器本身也吃资源。常驻内存几百 MB,日志量大时 CPU 明显上升,机器紧张就把采样率调低,先保关键服务,采样率调低之后检索结果里会出现缺口,得提前告知使用方。
传输要考虑带宽。每天几十 GB 走公网传到中心,出口会被占掉一块,尽量放内网或者错峰传,别和业务高峰抢,压缩后再传能省三成带宽,代价是采集端 CPU 略高。
索引字段别贪多。每行都拆成字段,存储成本翻几倍;只索引时间、级别、服务名、请求编号,够用且便宜,改索引字段等于重建索引,动手前先把存储算好。
保留策略两边对齐。中心按索引滚动删除,本地按份数删除,规则不一致会出现本地删了中心还留着的尴尬,两边都按同一个保留天数配,差一天就会多存一整天的量。
采集失败要能看见。agent 挂掉不会自己喊,要有独立的心跳检查,否则日志断几天都没人知道,心跳检查放独立监控里,和业务告警分开。
小团队先用轻量方案。几台机器、每天几 GB 的量,一个单机采集加简单检索页面就够,不必一上来就上完整栈,轻量方案也留好扩容接口,量涨上来再换。
大容量盘位和SSD怎么分工选机
日志型负载的第一需求是容量和顺序写。机械盘顺序写能跑一百多 MB 每秒,放归档和冷日志完全够,单位成本最低,盘位多还能顺手做冗余,阵列之后可用容量要打折,估算时把这点算进去。
热日志和高并发小文件要靠固态盘。容器运行时频繁写 json 文件、索引库不断刷盘,这些随机写场景机械盘延迟会拖垮整个服务,换成固态后响应立刻不一样,判断方法很简单,看磁盘等待队列和平均延迟。
混合布局最实用。系统盘和小数据库放固态,日志与归档放机械大盘,两者分开还能避免日志写满把系统一起拖死,出问题也好定位,日志盘写满时业务盘还能正常读写,恢复窗口大得多。
具体机型可以这样对照。要容量就把六千 GB 的 SAS 盘配上一百二十八 GB 内存,跑日志收集和归档很宽裕,云途这档机型就是这种思路;要随机写性能就选两 TB 固态那一档,容器密度高的时候更稳,同价位的另一条路可以对照着看,两台都按四十 TB 流量算,长期占用高的话再往上加档。买之前把盘位、接口和带宽一起确认,别只看容量数字。
带宽和流量也要算进去。日志外传、备份同步都吃流量,四十 TB 的月额度对多数中小站点够用,视频类业务要单独评估,流量快满时先看是谁在传,备份和日志各占多少一查便知,再决定要不要往上加额度。
热门新闻
-
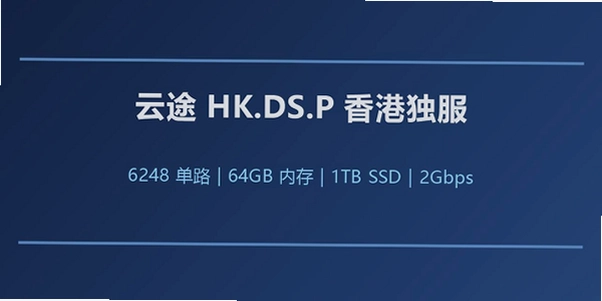
香港 1TB SSD 独服怎么选
云途 HK.DS.P 是香港独服里的中高配机型,单路 Intel Xeon Gold 6248(20 核 40 线程)、64GB 内存、1TB 全闪固态,端口 2000Mbps、月流量 40TB,月付 750 元,香港机房免备案。本篇从配置拆解、存储与端口配比、机房线路、适用业务到价格判断逐项说明,帮你在挑选香港独服时把参数和实际需求对上。
发布日期:2026-11-05 12:43:35
-
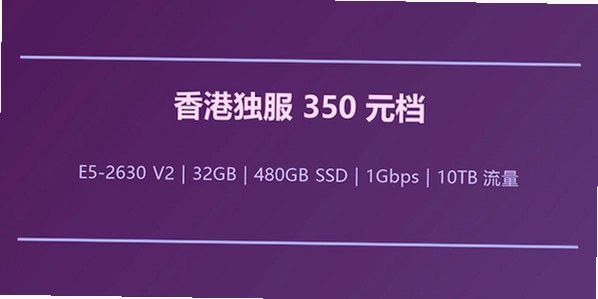
350 元的香港独服能跑什么
预算三百多块想做香港的机器,最常见的纠结是配置表看不懂、也不知道够不够用。这篇从用途倒推着讲:这个价位拿到的基本是上一代平台的整机独服,6 核 12 线程、32GB 内存、480GB SSD、1Gbps 独享口,跑多站点、私有网盘、轻量数据库这些活够用,碰上转码和编译这类持续吃 CPU 的事就吃力。内存怎么分、盘和流量怎么规划、下单前该确认哪些细节,文中都按实际踩过的顺序写了一遍。
发布日期:2026-11-06 11:43:52
-
独服和VPS怎么分工才省钱
预算就那么多,全买独服养不起,全用 VPS 又怕哪天扛不住,这大概是每个自己管站的人都会纠结的问题。其实不用二选一,把活拆开看,稳定的部分沉在独服上,变化的部分浮在 VPS 上,是眼下最省钱也最不容易出事的做法,这篇讲怎么判断哪块放哪、两边怎么连、账怎么算。
发布日期:2026-11-14 01:04:59
-
容器日志把磁盘写满怎么办
容器一跑起来,日志就成了没人管的黑洞:单文件没有上限、调试输出忘了关、异常时同一行错误刷几万次,某天早上根分区就只剩几个百分点。这篇按日志怎么长大、轮转参数怎么设、留多久合适、盘不够了补盘还是换机、集中收集之后本地还留不留、大容量盘和固态盘怎么分工的顺序讲,含可直接改的参数和按量估算的方法。
发布日期:2026-11-15 15:36:07
我要评论 查看全部评论 (0)>>