
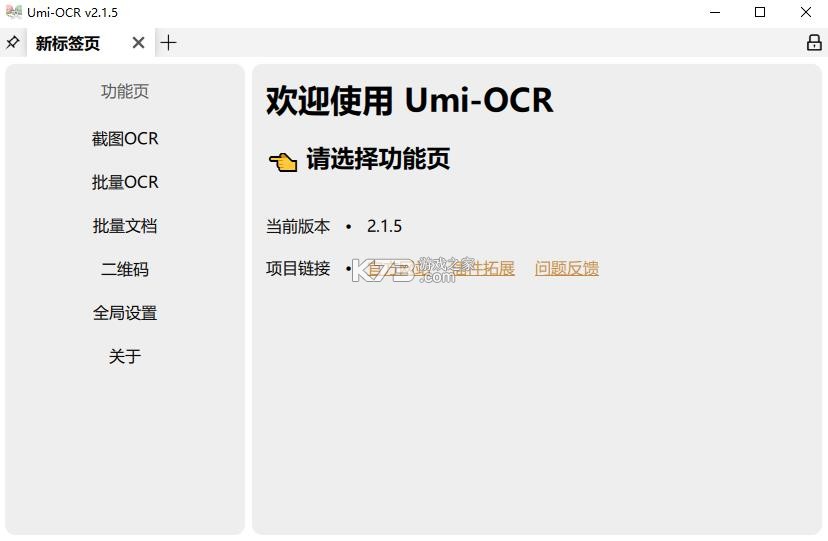
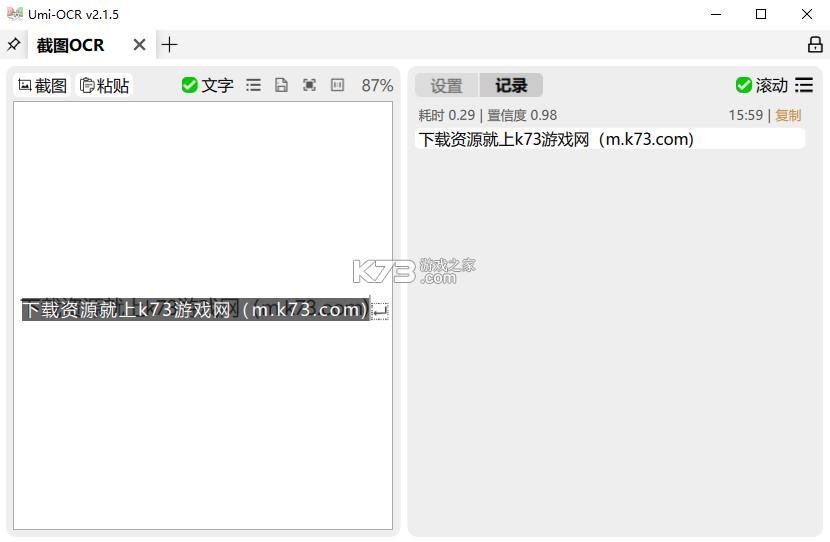
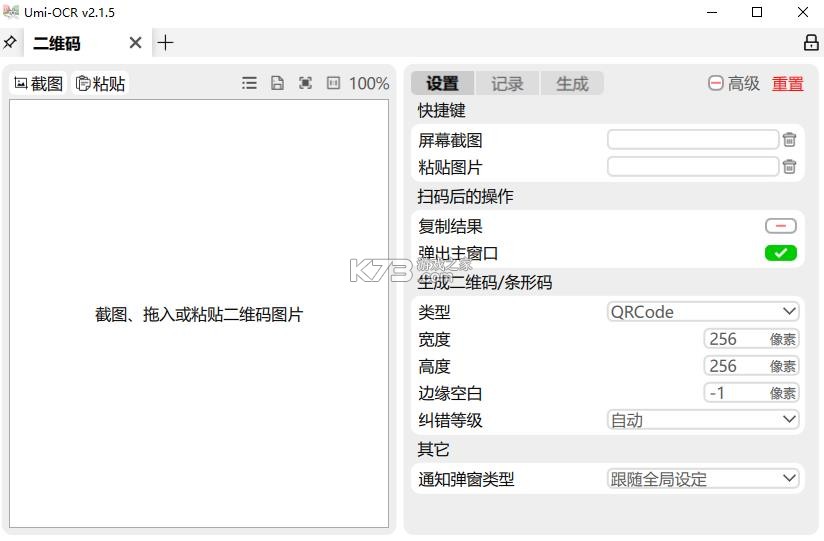
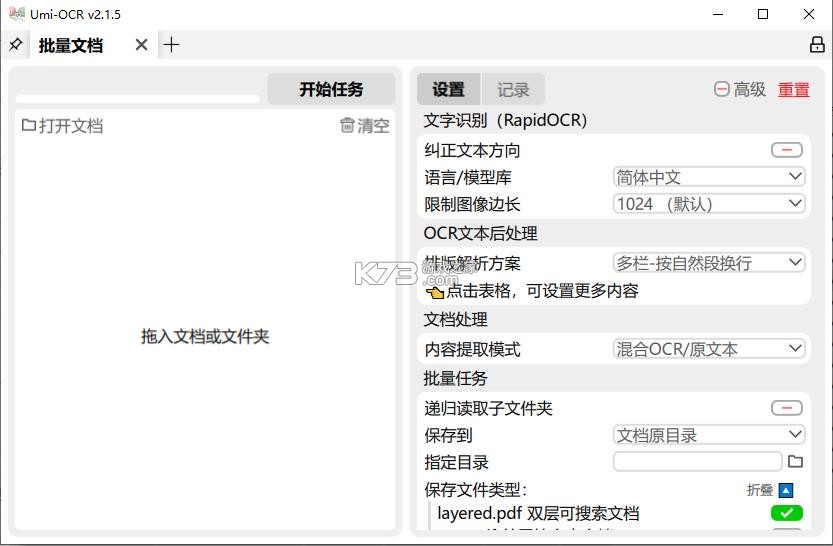
《Umi-OCR图片文字提取工具》作为一款开源免费的桌面端OCR应用,彻底改变了传统文字识别繁琐低效的局面。它不仅仅是一个简单的取字器,更集成了截图识别、批量处理、文档解析以及二维码生成等多重实用功能。对于经常需要处理纸质文档扫描件或屏幕截图的用户而言,其离线运行的特性确保了数据安全,无需担心隐私泄露。软件采用了模块化标签页设计,用户可以根据实际需求灵活开启所需功能,避免了界面的臃肿感。无论是学生整理笔记、程序员提取代码片段,还是办公人员转换表格数据,这款工具都能通过高精度的识别算法和智能化的后处理方案,将杂乱无章的图片文字转化为清晰有序的文本内容,极大提升了工作效率。
- 完全离线运行,保障数据隐私安全
- 支持多种图片格式批量导入识别
- 智能文本后处理,自动优化排版换行
- 独创忽略区域功能,有效排除水印干扰
- 多语言界面自适应,操作门槛极低
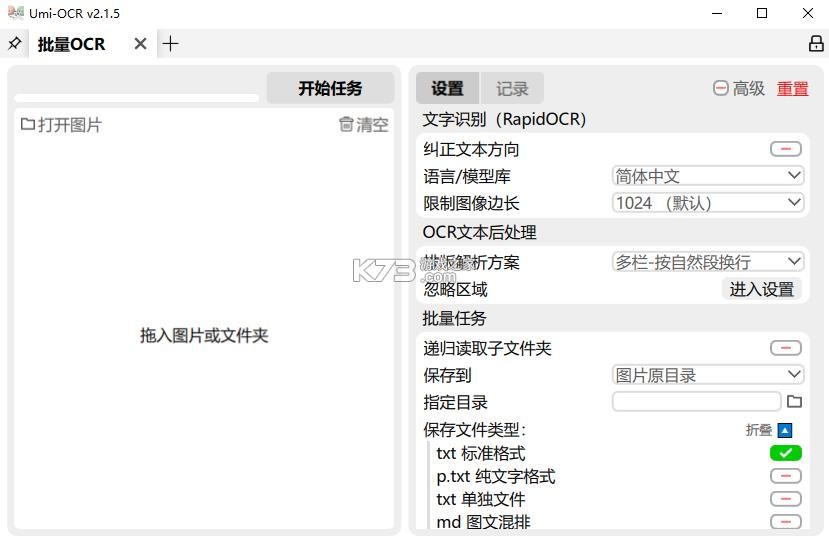
在使用《Umi-OCR图片文字提取工具》进行批量OCR任务时,很多用户会遇到图片中存在水印、LOGO或者无关装饰性文字的问题,这些元素往往会被错误识别为正文内容,导致最终输出的文本混乱不堪,需要大量人工校对。此时,“忽略区域”功能就显得尤为重要。这一功能允许用户在图片上绘制矩形框,指定某些区域内的文字不被识别引擎处理。
具体操作步骤非常直观:首先确保你处于“批量OCR”标签页,并在右侧设置栏中进入“忽略区域编辑器”。这里有一个关键的操作细节需要注意,你需要按住鼠标右键(而非左键)在预览图上拖拽绘制多个矩形框。这些框选的区域越大越好,务必完全包裹住所有可能出现的水印位置,因为OCR引擎是基于整个文本块进行判断的,只有当完整的文本块完全落在忽略区域内时,该部分才会被剔除。如果只框选了水印的一部分,剩余的字符仍可能被识别出来。例如,在一个包含代码截图的示例中,黄色边框标记的深色矩形即为忽略区,位于其中的变量名会被忽略,而边缘的其他代码行则正常保留。此外,不同版本的《Umi-OCR图片文字提取工具》可能在交互逻辑上略有差异,但核心原则一致:精准定位干扰源,大范围覆盖以确保效果。对于具有固定水印位置的文档,此功能能节省至少百分之五十的后期清洗时间。若发现忽略效果不佳,请检查是否误用了左键绘制,或确认矩形框是否真正覆盖了目标文本块的边界。
建议在进行大规模批量任务前,先选取几张典型样张进行测试,调整框选范围直至输出结果纯净为止。这种精细化的控制能力,体现了《Umi-OCR图片文字提取工具》在处理复杂图像场景时的专业性与灵活性,使其不仅仅局限于简单的文字提取,更能胜任高质量的数据清洗工作。
| 功能模块 | 适用场景 | 操作要点 |
|---|---|---|
| 截图OCR | 即时提取屏幕文字 | 快捷键唤起,划选复制 |
| 批量OCR | 大量图片文件转换 | 支持txt/json/md/csv导出 |
| 文档识别 | PDF/EPUB等电子书 | 生成双层可搜索PDF |
| 二维码工具 | 扫码或生成码 | 支持19种协议,纠错等级可调 |
《Umi-OCR图片文字提取工具》在设计之初就充分考虑了全球化用户的需求,因此内置了完善的多语言支持系统。默认情况下,软件在首次启动时会自动检测当前操作系统的语言设置,并据此切换相应的界面语言,这意味着大多数中文Windows用户打开软件后直接看到的是简体中文界面,无需任何额外配置。然而,在某些特殊场景下,比如用户希望使用英文界面以熟悉国际版术语,或者系统语言设置为繁体中文但希望使用简体显示,就需要手动进行调整。手动切换语言的路径非常清晰,用户只需点击主界面上的“全局设置”按钮,通常在侧边栏或顶部菜单中可以找到。进入设置页面后,向下滚动查找“语言/Language”选项。在这里,你会看到一个下拉列表,包含了简体中文、繁体中文、英语、日语等多种主流语言。选择你期望的语言后,软件通常会提示重启生效或直接即时刷新界面元素。
值得注意的是,部分高级字体渲染问题可能与语言切换有关,如果发现切换后出现乱码或布局错位,可以尝试同时调整“界面主题”或“字体大小”来缓解。对于开发者或技术人员,理解语言包的结构有助于后续可能的插件开发或本地化贡献。此外,语言切换不影响OCR引擎本身的识别能力,因为现代OCR模型大多是多语言的,无论界面显示何种语言,识别出的文本内容始终忠实于原图。如果在切换过程中遇到界面卡顿,建议检查显卡驱动是否正常,或在“渲染器”设置中关闭硬件加速尝试解决。这一细节功能体现了《Umi-OCR图片文字提取工具》对用户个性化体验的重视,使得不同背景的用户都能无障碍地使用这款强大的生产力工具,降低了学习成本,提升了软件的整体易用性和亲和力。
原始OCR识别出来的文本往往缺乏合理的段落结构,表现为每行都强制换行,或者多栏布局的文字顺序错乱,这给后续的阅读和编辑带来了巨大麻烦。《Umi-OCR图片文字提取工具》提供的“文本后处理”功能正是为了解决这一痛点而生。该功能位于截图OCR和批量OCR的设置选项中,提供了多种预设方案供用户选择。其中,“多栏-按自然段换行”是最常用的模式,它能够智能识别图片中的多栏布局,并根据自然段的规则重新组合句子,使输出结果接近原文档的排版习惯,适合处理书籍、杂志等复杂版面。“单栏-总是换行”则适用于那些不需要合并段落的简单列表或代码片段,保持每一句独立成行。而对于需要将分散的句子合并成一整段的情况,可以选择“无换行”方案,这在提取长篇文章摘要时尤为有用。特别值得一提的是“单栏-保留缩进”方案,这是针对程序代码截图优化的,它能完整保留行首的空格和制表符,确保复制出的代码可以直接编译运行,不会出现语法错误。还有一种“不做处理”模式,即直接输出OCR引擎的原始结果,适合对识别精度有极高要求且愿意自行排版的用户。
所有方案均能自动处理横排和竖排文字(需引擎支持),极大地简化了用户的操作流程。在实际使用中,用户应根据源图片的类型选择合适的方案,必要时可在识别记录栏中手动微调。这种灵活的排版解析能力,让《Umi-OCR图片文字提取工具》不仅是一个识别器,更是一个智能的文本整理器。
尽管《Umi-OCR图片文字提取工具》以其轻量级和高稳定性著称,但在部分老旧硬件或特定显卡驱动的电脑上,用户可能会遭遇界面闪烁、UI元素错位甚至程序闪退等问题。这类情况通常与软件默认的硬件加速渲染机制有关。为了解决这一兼容性难题,用户可以深入“全局设置”中的“界面和外观”板块,找到“渲染器”选项。在这里,软件提供了多种渲染方案供切换,包括DirectX、OpenGL以及纯软件渲染等。当遇到截屏闪烁或窗口拖动异常时,建议优先尝试切换到非硬件加速的渲染模式,虽然这可能会略微降低界面动画的流畅度,但能显著提升程序的稳定性和兼容性。
此外,更新显卡驱动程序也是常见的修复手段,过时的驱动可能导致图形API调用失败。如果问题依旧存在,检查是否有其他占用GPU资源较大的后台程序也是一个不错的思路。对于MacOS用户,由于平台架构差异,偶尔会出现高分辨率屏幕下的缩放模糊问题,这可以通过调整系统显示设置或软件内的DPI适配来解决。
《Umi-OCR图片文字提取工具》的开发团队也持续发布补丁来优化各平台的运行表现,保持软件版本更新是预防此类问题的最佳途径。通过这些细致的故障排查步骤,绝大多数用户都能恢复软件的正常运行状态,继续享受高效便捷的OCR服务。
音频提取软件是能够直接提取音频的app,这里是免费的音频提取器,能够下载音频提取软件免费版,随时进行音乐的提取。对于需要剪辑音乐自媒体工作的人来说,是非常方便的软件了。
 下载
Umi-OCR图片文字提取工具 98.58 MB | 电脑版免费下载
 下载
剪映极速版 324 MB | 下载
 下载
剪映 324 MB | app
 下载
音频提取转换王 139.99 MB | 安卓app下载
 下载
会剪音频 67.97 MB | app
 下载
玩酷电音 54.14 MB | 正式版
 下载
音频编辑器 86.02 MB | 破解版已付费
 下载
视频音频转换器 46.05 MB | 免费软件
你是不是在找一款免费好用的录屏工具呢?这里或许有你要找的那款。工具全部免费下载使用,能让你录制出高清无损的视频音频内容,快捷进行编辑和分享。
下载
Umi-OCR图片文字提取工具 98.58 MB | 电脑版免费下载
 下载
即时回放 17.38 MB | 下载安装app
 下载
hookvip 7.3 MB | 官方正版下载
 下载
芦笋 33.44 MB | app
 下载
手机录屏 90.89 MB | app下载
 下载
看看录屏 55.8 MB | 官方app下载安装
 下载
droidcamx 1.89 MB | 官方版下载
 下载
xrecorder录屏大师 35.98 MB | 官方版
二维码识别app哪个最好?能识别二维码的软件有哪些?想要直接进行二维码识别可以在这里下载了,有着二维码识别软件在线功能,也有着二维码识别最新版提供,相信大家都有需要。
下载
Umi-OCR图片文字提取工具 98.58 MB | 电脑版免费下载
 下载
扫一扫二维码大师 61.79 MB | app下载免费
 下载
扫一扫二维码管家 58.78 MB | app下载免费
 下载
文撷快扫 9.61 MB | 安卓app下载
 下载
支二维码免费扫扫 131.57 MB | 官方app下载安装
视频转文字软件哪个好用?很多人都在问这个问题,还有很多人问有没有免费的视频转文字软件?这里分享的就是好用的视频转文字软件,并且是免费的视频转文字软件,能够让大家轻松进行视频转成文字,解放你的双手不用再自己手打了。
下载
Umi-OCR图片文字提取工具 98.58 MB | 电脑版免费下载
下载
剪映 324 MB | app
 下载
飞书 309.74 MB | app安卓版
 下载
豆包ai 371.42 MB | 下载
 下载
腾讯会议 128.85 MB | app下载
 下载
讯飞听见 65.61 MB | 2026最新版
 下载
语音转换文字 141.05 MB | app免费版
 下载
百度网盘 55.61 MB | 手机版
我要评论 查看全部评论 (0)>>

 咒术回战幻影夜行
 手动挡停车场
 和平精英
 悟空浏览器
 千岛识物
 王者体验服
 四川e社保认证
 3a云游戏